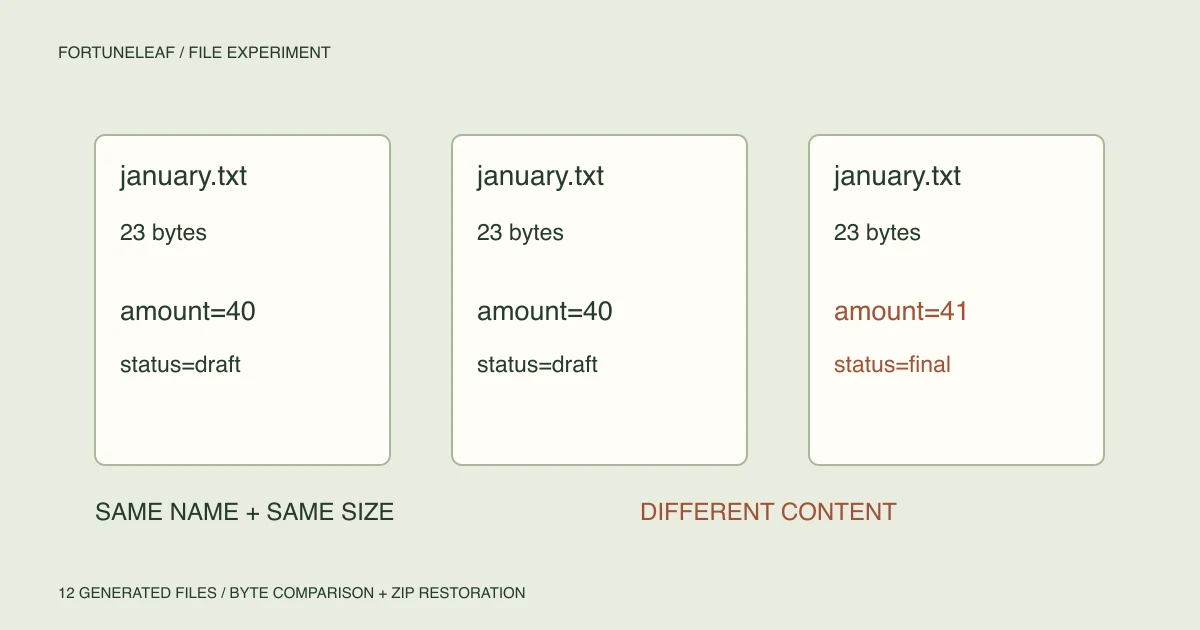
january.txt라는 파일이 세 개 있습니다. 크기도 모두 23바이트입니다. 그런데 두 개는 같은 초안이고, 나머지 하나는 금액과 상태가 바뀐 파일입니다. 이름과 크기가 같다는 이유로 하나만 남기면 서로 다른 내용을 잃습니다. 반대로 notes.txt와 notes-copy.txt는 이름이 달라도 같은 5바이트를 담고 있습니다.
이 차이를 직접 확인하려고 작은 파일 12개를 만들었습니다. 내용을 비교한 뒤 ZIP으로 묶어 별도의 임시 폴더에 복원하자 12개 모두 원본과 일치했습니다. 복원본에서 파일 하나를 없애고 다른 하나의 내용을 바꾼 검사에서는 누락 한 건과 내용 불일치 한 건이 잡혔습니다. 실제로 코드를 실행한 결과이며, 개인 문서나 특정 백업 서비스의 성능을 시험한 것은 아닙니다.
어떤 파일을 만들었나
샘플 ZIP에는 초안과 최종 보고서, 이름을 바꾼 복사본, 길이가 같은 가격 기록, 줄바꿈 방식이 다른 파일, 유니코드 표현이 다른 한글 파일, 빈 파일이 들어 있습니다. 전체 목록 CSV에서 경로·바이트 수·SHA-256 값을 확인할 수 있습니다. 파일 이름과 내용은 전부 이 실험을 위해 만들었습니다.
경로는 12개이고, 서로 다른 바이트 내용은 10종입니다. 그렇다고 두 파일을 지워도 된다는 결론은 아닙니다. 서로 다른 프로젝트가 같은 내용을 각각 필요로 할 수도 있습니다. 이번에 확인한 것은 내용의 일치 여부이지 파일의 업무상 용도나 삭제 가능성이 아닙니다.
| 비교한 파일 | 크기 | 바이트 일치 | 이름·크기만 보면 놓치는 것 |
|---|---|---|---|
| reports/january.txt ↔ reports-copy/january.txt | 23 / 23 | 일치 | 이 쌍은 실제로 같은 초안입니다 |
| reports/january.txt ↔ reports-final/january.txt | 23 / 23 | 다름 | 이름과 크기가 같아도 금액·상태가 달랐습니다 |
| reports/notes.txt ↔ archive/notes-copy.txt | 5 / 5 | 일치 | 이름 변경이 내용 변경은 아니었습니다 |
| case/same-size-a.txt ↔ case/same-size-b.txt | 9 / 9 | 다름 | price=40과 price=41은 같은 길이를 차지합니다 |
| line/lf.txt ↔ line/crlf.txt | 10 / 11 | 다름 | 줄바꿈에 쓰는 바이트가 달랐습니다 |
| unicode/nfc.txt ↔ unicode/nfd.txt | 11 / 20 | 다름 | 같은 한글을 다른 유니코드 문자열로 표현했습니다 |
해시는 파일 이름보다 좁은 질문에 답합니다
코드는 파일을 바이너리로 읽어 SHA-256 값을 구하고, 위 여섯 쌍은 바이트 자체도 직접 비교합니다. Python hashlib 문서에서 해시값을 만드는 방식을 확인할 수 있습니다. 이번 여섯 비교에서는 해시 일치와 바이트 일치의 결과가 같았습니다. 이 값으로 의미·소유자·수정 이력·삭제 가능성까지 판단하지는 않습니다.
크기는 후보를 추리는 데 쓸 수 있지만 내용 확인을 대신하지는 못했습니다. 두 가격 파일은 마지막 줄바꿈까지 포함해 모두 9바이트입니다. 크기만으로는 어느 가격인지 알 수 없습니다. 실제 의미는 문서를 열어 살피고, 정확히 같은 내용인지는 바이트 비교로 확인해야 합니다.
화면의 글자가 같아도 바이트는 다를 수 있습니다
LF 파일은 줄바꿈에 1바이트, CRLF 파일은 2바이트를 씁니다. 두 파일이 텍스트 편집기에서 한 줄로 보이더라도 코드가 읽는 값은 다릅니다. 크기가 더 크다는 사실만으로 더 최신 문서라고 판단할 수도 없습니다.
한글 쌍은 ‘메모=가’와 줄바꿈을 UTF-8로 저장한 파일, 같은 문장을 NFD로 정규화한 뒤 저장한 파일입니다. Python 유니코드 문서는 정규화 형식을 설명합니다. 이번 입력은 줄바꿈을 포함해 각각 11바이트와 20바이트였습니다. 파일 내용의 인코딩 실험이며, 특정 파일시스템이 한글 파일 이름을 어떻게 처리하는지는 시험하지 않았습니다.
문자를 정규화한 뒤 비교하면 질문이 달라집니다. 문장을 대조하는 데는 도움이 될 수 있어도 저장된 원래 바이트가 그대로 살아 있는지 확인하는 검사는 아닙니다. 그래서 복원 검사에서는 원래 입력을 변환하지 않았습니다.
통과한 복원과 일부러 실패하게 만든 복원
고정된 샘플로 ZIP을 만든 다음 새 임시 폴더에 풀었습니다. 원래 목록과 복원 목록의 경로·크기·해시를 맞추고 바이트도 직접 비교했습니다. 첫 결과는 12개 일치, 누락 0개, 예상 밖의 경로 0개, 내용 불일치 0개였습니다.
다음에는 그 복원본을 복사해 zero/empty.txt를 없애고, 최종 보고서의 금액을 41에서 00으로 바꿨습니다. 바꾼 보고서의 크기는 여전히 23바이트입니다. 검사 결과는 10개 일치, 파일 누락 1개, 내용 불일치 1개였습니다. 개수만 세면 누락은 알 수 있지만 같은 크기의 수정이 무엇인지 알 수 없습니다. 크기를 대조하는 방법도 그 수정은 잡아내지 못했습니다.
0바이트 파일은 의도적으로 넣었습니다. 빈 파일이 자리표시자 등으로 필요한 경우가 있으므로 원래 목록에 포함했습니다. 작거나 비어 있다는 이유로 불필요하다고 가정하지 않고, 기대한 목록이 온전히 복원됐는지 검사한 것입니다.
개인 폴더를 읽지 않고 같은 결과 확인하기
Python 코드를 내려받고 이미 Python 3가 있는 환경이라면 저장한 폴더에서 python3 file-check.py를 실행할 수 있습니다. 입력 경로를 받는 기능은 없습니다. 자체 임시 폴더에 샘플만 만들고 JSON 결과를 출력한 다음 임시 파일을 정리합니다. 정리 방식은 TemporaryDirectory 문서를 참고할 수 있습니다. 코드 실행에 네트워크나 추가 패키지는 필요하지 않습니다.
전체 실행 결과와 경로·바이트 수·여섯 비교·복원 결과를 맞춰 보세요. 실행한 컴퓨터의 Python 버전 표시는 달라질 수 있습니다. 실행하지 않고 샘플 ZIP과 CSV를 열어 입력을 살펴볼 수도 있습니다.
실제 정리에서는 무엇을 결정해야 하나
우선 원래 경로를 보존하고 어느 프로젝트나 사람이 어떤 버전을 필요로 하는지 확인해야 합니다. 이름과 크기로 후보를 추린 뒤 내용을 살피고 필요한 파일을 비교하세요. 삭제는 의존 관계와 복원 가능한 사본을 확인한 다음 별도로 결정할 일입니다. 이번 코드는 독자의 실제 문서에 중복 제거를 실행하지 않습니다.
같은 임시 작업 공간에서 ZIP 복원이 됐다는 결과는 디스크 고장·랜섬웨어·계정 상실 때도 백업이 살아남는다는 증거가 아닙니다. 권한·수정 시각·심볼릭 링크·앱 전용 묶음·클라우드 이력·별도 물리 장치는 시험하지 않았습니다. 실제 백업은 자신에게 필요한 복구 상황에서 확인해야 합니다. 이번 실험이 보여준 범위는 구체적입니다. 이 12개 샘플에서는 이름과 크기만으로 내용 일치를 판단할 수 없었고, 경로와 내용을 함께 검사하자 의도한 누락과 같은 크기의 수정을 찾았습니다.